Kiedy słyszymy ETL lub ELT pierwsze co przychodzi nam na myśl to transformacje, źródła oraz miejsce zapisu. Zastanawiamy się nad agregacją, odpowiednimi relacjami oraz jak ma wyglądać tabela końcowa. Natomiast jest wiele elementów na które również należy zwrócić uwagę, aby uniknąć błędów lub dodatkowej pracy w przyszłości.
Pierwszym takim elementem jest profilowanie danych (ang. Data Profiling). Jest to proces, w którym analizujemy nasze źródła oraz docelową strukturę danych, aby lepiej zrozumieć ich składnię oraz różnice pomiędzy nimi. Krótko mówiąc – sprawdź, co aktualnie masz, zanim przejdziesz do tworzenia „pipeline”. Dlaczego jest to aż tak ważne? W pracy inżyniera danych często pracujemy z wieloma źródłami, korzystamy z różnych narzędzi transformacji, a docelowe miejsce zapisu nie musi być zawsze tym samym systemem lub formatem plików. Załóżmy scenariusz, gdzie potrzebujemy zebrać informacje o zamówieniach z dwóch systemów źródłowych, zunifikować, a następnie zapisać do hurtowni danych.
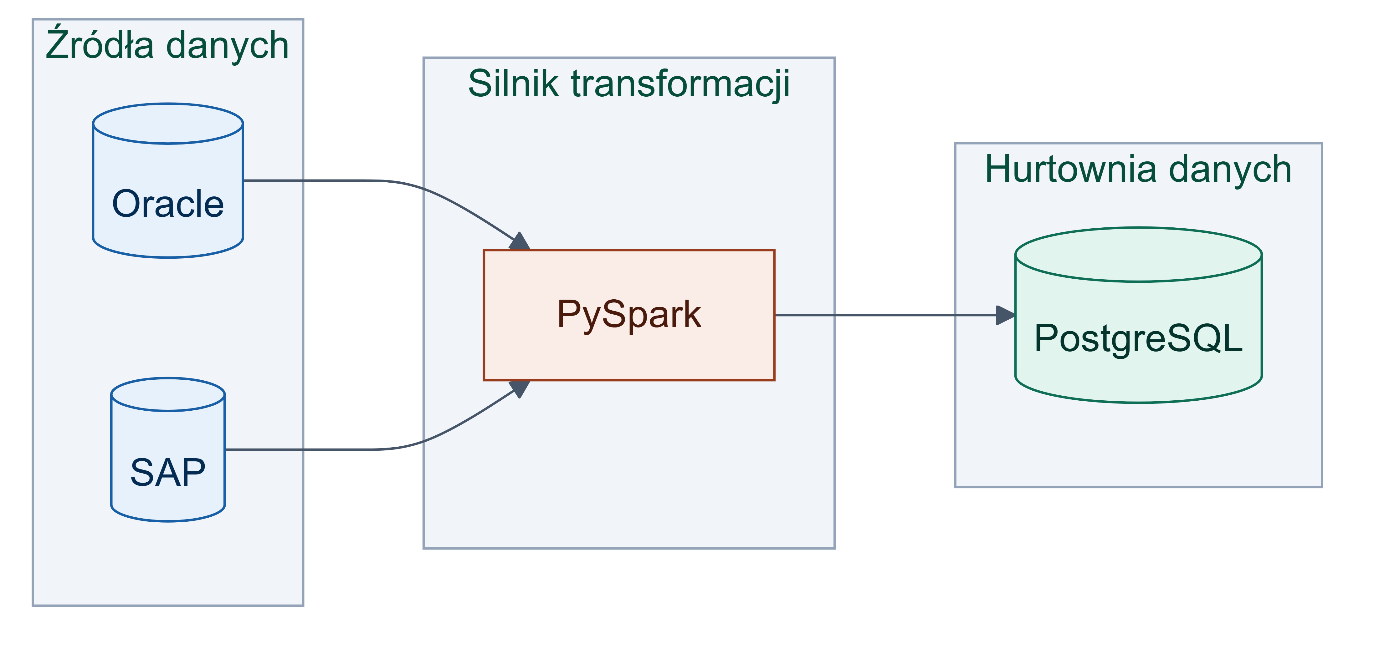
Nie wydaje się to trudne, prawda? Dwa źródła danych, oba korzystają z formatu tabeli. Zajrzymy teraz do przykładowych struktur danych w obu źródłach.
| Kolumna | Typ danych (Oracle) | Przykład 1 | Przykład 2 | Przykład 3 |
|---|---|---|---|---|
| ORDER_ID | NUMBER(10) | 500001 | 500002 | 500003 |
| CUSTOMER_ID | NUMBER(10) | 1001 | 1002 | 1001 |
| ORDER_DATE | DATE | 10.02.2024 | 11.02.2024 | 12.02.2024 |
| STATUS | VARCHAR2(20) | NEW | SHIPPED | CANCELLED |
| PRODUCT_CODE | VARCHAR2(30) | PRD-2231 | PRD-8842 | PRD-1190 |
| QUANTITY | NUMBER(6) | 4 | 1 | 2 |
| UNIT_PRICE | NUMBER(12,2) | 129.99 | 899.00 | 45.50 |
| TOTAL_AMOUNT | NUMBER(14,2) | 519.96 | 899.00 | 91.00 |
| CURRENCY | CHAR(3) | PLN | PLN | EUR |
| CREATED_AT | TIMESTAMP | 10.02.2024 08:14 | 11.02.2024 13:40 | 12.02.2024 16:05 |
| Kolumna | Typ danych (SAP) | Przykład 1 | Przykład 2 | Przykład 3 |
|---|---|---|---|---|
| VBELN (nr dokumentu sprzedaży) | CHAR(10) | 600001 | 600002 | 600003 |
| KUNNR (nr klienta) | CHAR(10) | 100045 | 100078 | 100045 |
| ERDAT (data utworzenia) | DATS(8) | 20240210 | 20240211 | 20240212 |
| AUART (typ zamówienia) | CHAR(4) | OR | OR | RE |
| VKORG (organizacja sprzedaży) | CHAR(4) | 1000 | 1000 | 2000 |
| NETWR (wartość netto) | CURR(15,2) | 519.96 | 899.00 | 91.00 |
| WAERK (waluta) | CUKY(5) | PLN | PLN | EUR |
| AUGRU (powód zamówienia) | CHAR(3) | (puste) | 1 | 4 |
| LOEVM (oznaczenie do usunięcia) | CHAR(1) | (puste) | (puste) | X |
Pierwszy „problem” został już rozwiązany. Dodałem w nawiasach obok nazw kolumn w SAP ich znaczenie. Bez tego ciężko się domyśleć jakie informacje dostarczają nam tabele. Drugim problemem jest kolumna „Typ danych”. Każda technologia/silnik/narzędzie/itd. posiada często swój własny zestaw typów danych oraz mechanizmy do obsługi NULL. W bazach danych Oracle mamy dla łańcuchów znakowych typ VARCHAR2, SAP korzysta z CHAR, PySpark ma standardowy STRING, a nasza hurtownia danych, PostgreSQL zapisuje łańcuchy znakowe pod VARCHAR. Kolejnym przykładem jest data – Oracle ma DATE, w SAP widzimy DATS, który oznacza łańcuch znakowy w formacie YYYYMMDD, PySpark zapisze to z wykorzystaniem modułów datetime albo pendulum, a PostgreSQL będzie tutaj miał podobnie jak Oracle, czyli DATE. Wspomniałem o NULL i tutaj też jest ciekawie – Oracle, PostgreSQL korzystają z frazy NULL, PySpark ma swój typ None, ale w SAP NULL już nie istnieje – jest on mapowany zależnie od typu danych. Dla CHAR będzie to brak znaków, czyli pusty łańcuch znakowy, ale DATS wykorzysta zapis „00000000”. Podobnie z prawda/fałsz. W językach programowania jest dostępny typ bool/boolean, ale w bazach danych najczęściej prezentowane to jest za pomocą łańcucha znakowego Y/Yes/N/No albo liczbą całkowitą 0/1.
Drugim problemem jest mapowanie danych. Poza dopasowaniem kolumn musimy również (jeżeli jest to oczywiście możliwe) dopasować wartości. Ten problem nie występuje pomiędzy CURRENCY (Oracle), a WAERK (SAP) – po prostu przepisujemy informacje do wspólnej tabeli. Ale co mamy zrobić z informacją o dacie zamówienia? W Oracle mamy dwie informacje: ORDER_DATE oraz CREATED_AT. SAP posiada tylko jedną kolumnę: ERDAT. Tutaj Data Engineer musi współpracować z analitykami oraz biznesem, aby ustalić warunki mapowania danych oraz ich łączenia. Biznes może ustalić, że kolumna ORDER_DATE jest równa ERDAT, ale chce również informacje CREATED_AT w hurtowni danych. W takiej sytuacji najczęściej będziemy ustawiać NULL.
Ostatnim krokiem, który Data Engineer powinien wykonać jest dodanie kolumn technicznych. Są to dodatkowe kolumny, które dostarczają metadanych oraz pozwalają optymalizować kolejne procesy. Przykładowo:
- Dodanie kolumn z informacjami skąd pobrano rekord oraz kiedy go zaktualizowano. Dzięki temu możemy zweryfikować, czy załadowaliśmy wszystkie dane z wybranego źródła.
- Kolumna techniczna o nazwie „source_date”, która jest konkatenacją wartości z kolumny SourceSystem oraz ProcessDate. Dzięki temu możemy utworzyć partycjonowanie na jednej kolumnie, a następnie korzystać z tej kolumny podczas odczytywania danych dla kolejnych procesów.
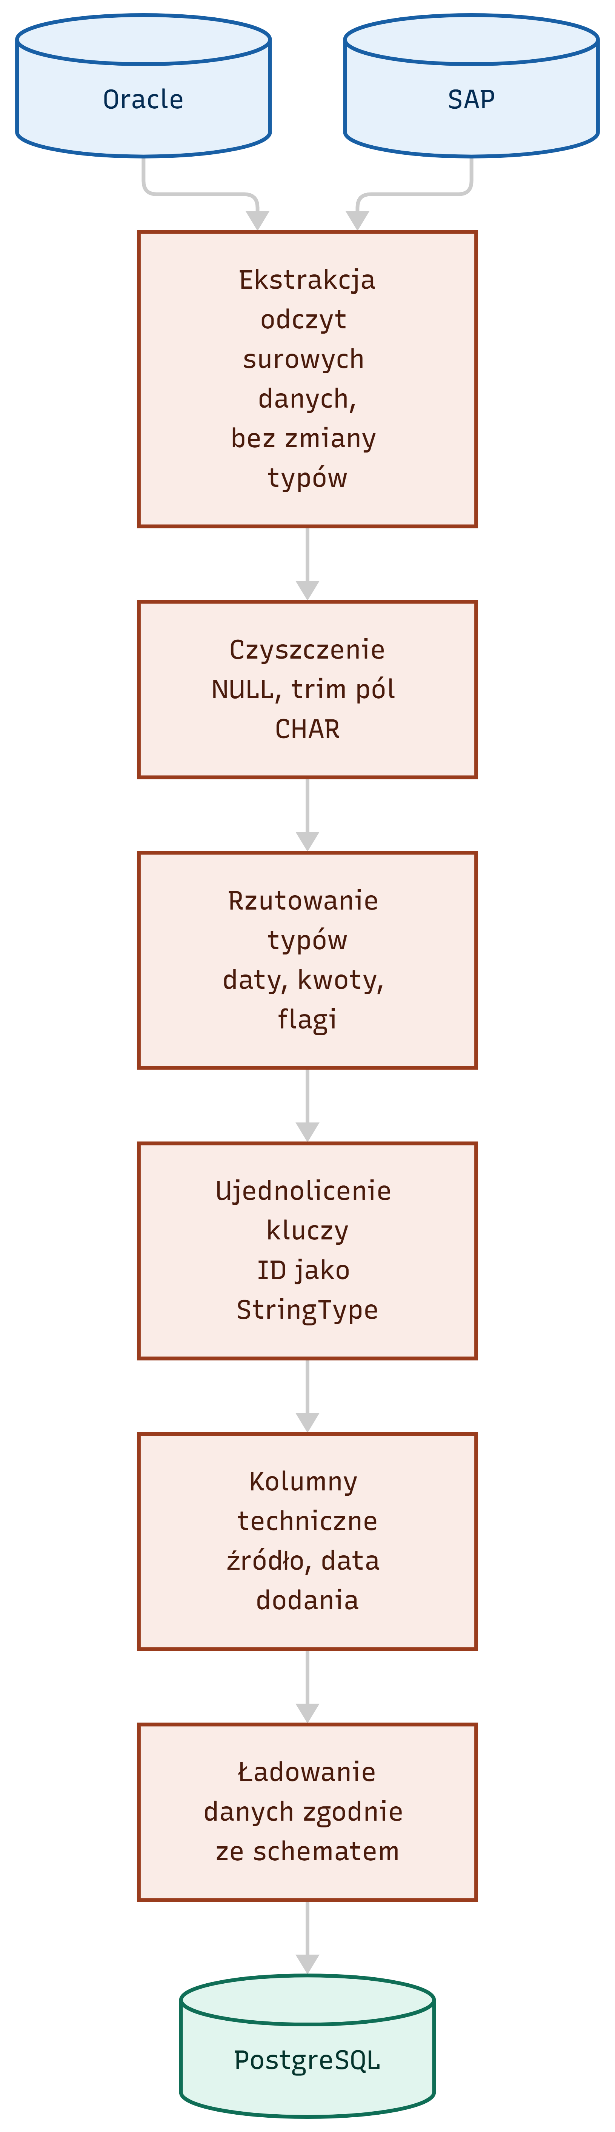
Tak będzie prezentował się nasz szablon przepływu danych:
Na koniec ogólne zasady przy projektowaniu transformacji, niezależnie od silnika:
- Nigdy nie mapuj wprost 1:1 typu źródłowego na docelowy — zawsze przechodź przez jawne rzutowanie (np. funkcja cast w PySpark), żeby uniknąć cichej utraty precyzji lub formatu.
- Klucze biznesowe (ID, numery dokumentów) traktuj jako łańcuchy znakowe aż do momentu, gdy masz pewność co do formatu.
- Kwoty i wartości pieniężne zawsze typy danych z jawną precyzją np. Decimal, Numeric — różnice w zaokrągleniach między systemami są częstym źródłem błędów w hurtowniach danych.
- Wartości puste/domyślne różnią się między systemami — w naszym przykładzie Oracle używa NULL, SAP często pustego stringa lub „00000000” dla dat — normalizacja do NULL powinna nastąpić w warstwie transformacji przed zapisem do miejsca docelowego.
- Kodowanie znaków — systemy mogą korzystać z różnych systemów kodowania. SAP bywa w kodowaniu specyficznym dla systemu (np. z uwzględnieniem znaków narodowych w polach CHAR) — warto zweryfikować UTF-8 przy ekstrakcji.
- Nie używamy pustych znaków jako uzupełnienie – jeżeli zależy nam na stałej długości tekstu np. numer EAN to nigdy nie uzupełniamy go białymi znakami np. „011” zamiast „ 11”. Niektóre narzędzia potrafią ignorować białe znaki na początku i na końcu tekstu!
Autor
Z IT jest związany już prawie 10 lat. Pracował w różnych sektorach związanych z danymi: od administratora baz danych, poprzez DataOps, a skończywszy na Data Engineer. Zajmuje się również planowaniem i zarządzaniem zespołów (aktualnie pracuje jako Technical Lead w firmie Kantar). Autor wideo kursów i książek o tematyce technicznej. Jak ma trochę wolnego czasu to spędza go na czytaniu książek fantasy lub graniu w gry komputerowe.